Rated 5 star on

Procesamiento de Lenguaje Natural para Empresas: La Guía
Respuesta rápida
El procesamiento del lenguaje natural convierte el texto no estructurado en datos estructurados en los que un sistema puede actuar. Cinco puestos de trabajo cubren la mayoría de las necesidades empresariales: clasificar mensajes de entrada, extraer campos de documentos, resumir texto largo, leer el sentimiento a escala y enrutar el trabajo a la persona adecuada. Comience con un tipo de documento, y decida qué precisión es suficiente antes de construir.
La mayoría de lo que un negocio sabe está escrito en una forma que ningún sistema puede usar. Emails, contratos, opiniones, entradas, facturas, notas de reunión, formularios manuscritos. Alguien lee cada uno, decide lo que es, y escribe un resumen en algún lugar. Esa lectura y clasificación es una gran parte de cada día administrativo, y es exactamente lo que hace NLP.
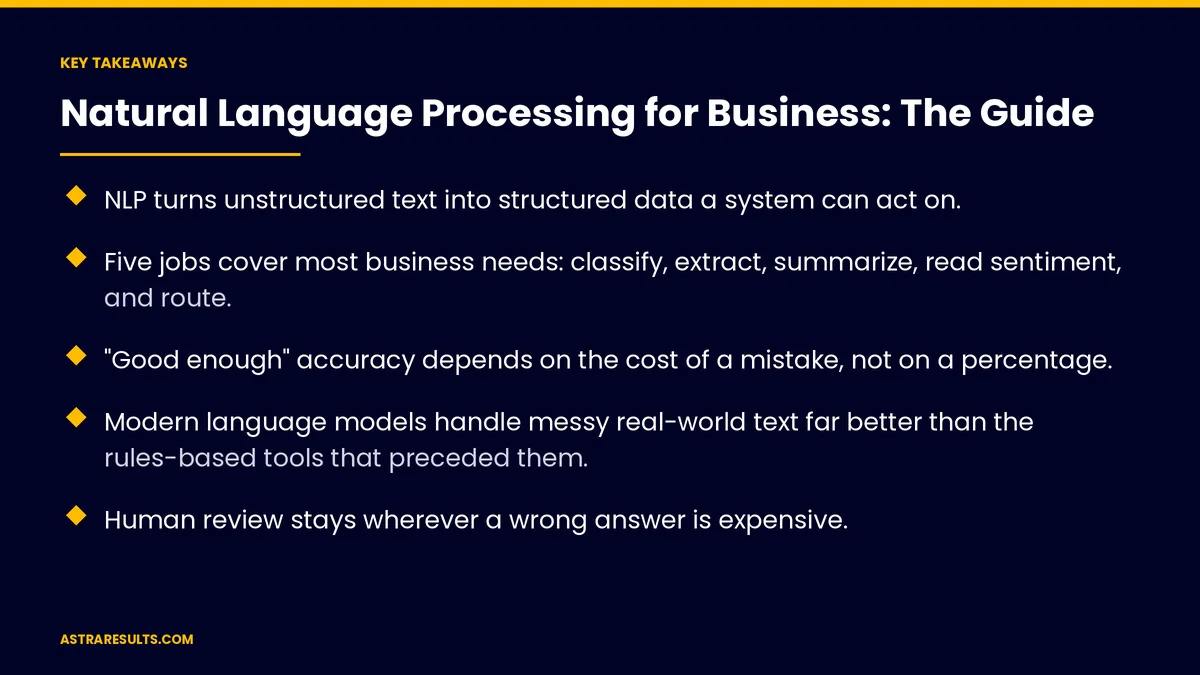
Puntos Clave
- NLP convierte el texto no estructurado en datos estructurados en los que un sistema puede actuar.
- Cinco trabajos cubren la mayoría de las necesidades empresariales: clasificar, extraer, resumir, leer sentimientos y ruta.
- La precisión "buena" depende del costo de un error, no de un porcentaje.
- Los modelos de lenguaje moderno manejan el texto desordenado del mundo real mucho mejor que las herramientas basadas en reglas que los precedieron.
- La revisión humana permanece donde una respuesta equivocada es cara.
- Comience con un tipo de documento de alto volumen y una base de referencia medida.
Publicado: 18 de septiembre de 2026 | Tiempo de lectura: ~13 minutos | Categoría: NLP
Esta guía explica NLP en términos de operador: lo que hace con el texto, los cinco trabajos que hace bien para la mayoría de las empresas, qué precisión es suficiente, dónde falla, y cómo empezar con un tipo de documento. Ponga claramente: texto es datos que nadie ha estructurado todavía.
Orientación para propietarios y operadores. Nada aquí es asesoramiento legal o técnico. El procesamiento de documentos que contengan información personal, financiera, sanitaria o jurídica está sujeto a normas de privacidad y sector que varían según la jurisdicción y deben ser revisados con el abogado.
En este Playbook
- Qué hace NLP con texto
- Job uno: clasificar el texto de entrada
- Job dos: extracción de campos de documentos
- Job tres: resumen
- Job 4: lectura de sentimientos a escala
- Job 5: enrutamiento y triaje
- ¿Qué precisión es suficiente?
- Donde NLP falla
- Privacidad y manejo
- Los primeros 90 días
- En la práctica, con Astra
Qué hace NLP con texto
- Lee. Toma un correo electrónico, un PDF, un formulario escaneado, una transcripción o una revisión, y entiende lo que dice lo suficientemente bien para trabajar con él.
- Clasifica. Decide qué tipo de cosa es: una queja, una solicitud de cotización, una factura, una cancelación, un cumplido.
- Extractos. Extrae los campos que importan: quién, qué, cuánto, cuándo, qué cuenta, qué producto.
- Resúmenes. Reduce una cosa larga a la versión corta que una persona necesita.
- Lee tono. Detecta si el cliente es feliz, frustrado, urgente o indiferente, a través de miles de mensajes a la vez.
- Lo que cambió recientemente. Older NLP se basó en palabras clave y reglas y rompió cualquier cosa inesperada. Los modelos de lenguaje moderno leen la forma en que una persona lo hace, entendiendo el contexto, los tipos, los idiomas esclavizados y mixtos, por lo que las mismas tareas que falló hace cinco años trabajan ahora, detalladas en la capa AI en automatización.
Job uno: clasificar el texto de entrada
Cada negocio recibe texto que tiene que ordenar antes de que alguien pueda actuar.
- La bandeja de entrada. Cientos de correos electrónicos al día en una dirección compartida: pedidos, preguntas, quejas, facturas de proveedores, spam. Alguien triages. NLP clasifica cada uno y lo dirige, por lo que la persona que maneja las quejas sólo ve quejas.
- Billetes de apoyo. Categorizado por tipo de emisión y urgencia a la llegada, antes de que un humano los lea.
- Formas y mensajes web. Ordenado en la cola correcta con la prioridad correcta, en segundos.
- Reseñas. Etiquetado por lo que se trata — servicio, precio, tiempo de espera, un lugar específico o empleado — por lo que los patrones aparecen sin leer cada uno.
- El resultado. Nada se sienta en la cola equivocada. Las cosas urgentes salen primero. Las horas del clasificador van a otra parte.
Job dos: extracción de campos de documentos
El trabajo de NLP de mayor rendimiento para la mayoría de las empresas, porque elimina el rekeying.
- Facturas. Vendor, fecha, line items, totals, due date, pull from PDFs and photos into accounts payable, with discordtches flagged.
- Compra órdenes y citas. Cliente, artículos, cantidades, precios, en el sistema de pedidos.
- Contratos. Partes, fechas, términos de renovación, obligaciones, períodos de aviso, en un registro que alguien puede buscar.
- Formularios y aplicaciones. Manuscrita o escrita, en registros estructurados.
- Documentos de envío y aduanas. Campos en el sistema logístico sin entrada manual.
- Una caverna. La exactitud de la extracción depende en gran medida de la calidad del documento. Los PDF limpios son excelentes. Las fotos de los recibos son buenas. La escritura fallida es un trabajo humano con ayuda de NLP, no el revés.
Job tres: resumen
Obtener la versión corta a la persona que lo necesita.
- Llama a las notas CRM. Una llamada de admisión de doce minutos se convierte en un resumen de cinco líneas con la necesidad del cliente, el resultado y el siguiente paso, en el registro antes de que termine la llamada.
- Reuniones en temas de acción. ¿Quién aceptó hacer qué cuando?
- Los hilos de correo electrónico largos. El estado de un hilo de catorce mensajes en tres frases para la persona acaba de añadir a él.
- Documentos para su examen. Los términos clave de un contrato de cuarenta páginas en una página, para la persona que decide si leer las cuarenta páginas.
- Comentarios y comentarios. Un mes de retroalimentación reducido a las cinco cosas que los clientes siguen diciendo.
- El guardia. Un resumen es un punto de partida, no un sustituto, donde el detalle tenga consecuencias.
Job 4: lectura de sentimientos a escala
Saber cómo se sienten miles de clientes sin leer miles de mensajes.
- Lo que produce. Para cada mensaje, una lectura: positiva, negativa, neutral y la emoción específica — frustrada, confusa, satisfecha, urgente. Agregado por tiempo, ubicación, producto o empleado.
- Reseñas. El tono cambió este mes. La mención del producto resultó negativa. Que empleado es nombrado con gratitud.
- Apoyo y ingesta. La frustración detectada en un mensaje desencadena una respuesta humana más rápida, el caso por el cual se sienta Normas de escalada.
- Encuestas y comentarios de texto abierto. Respuestas de texto libre agrupadas en temas en lugar de esquivar y olvidar.
- El límite. Sentencia es una señal, no un veredicto. El sarcasmo, las diferencias culturales en la expresión y los mensajes mixtos lo confunden. Indica a un humano hacia lo que leer; no reemplaza la lectura de los importantes.
Job 5: enrutamiento y triaje
Llevar cada pieza de texto a la persona correcta, con la urgencia correcta, sin un remitente.
- Reglas más lectura. Clasificación y sentimiento juntos deciden la cola y la prioridad. Un mensaje enojado sobre un error de facturación de una cuenta superior va al propietario de la cuenta, marcado urgente, en segundos.
- Detección de idiomas. Mensajes españoles a hablantes españoles, según Español como canal.
- Detección duplicada. El mismo cliente escribiendo tres veces sobre un problema se convierte en un caso, no en tres.
- La escalada. Cualquier cosa que el sistema no pueda clasificar con confianza va a una persona, marcada como incierta en lugar de adivinada.
- El efecto. El tiempo de respuesta cae para los mensajes que más importan, y nada se pierde en una bandeja de entrada general.
¿Qué precisión es suficiente?
Nadie debería comprar NLP en un porcentaje. La pregunta correcta es lo que un error cuesta.
- Errores de bajo costo. Etiquetando una revisión con el tema equivocado. Dirigir una pregunta general a la cola equivocada. Aquí, la precisión del noventa por ciento con fácil corrección es excelente, porque la alternativa no era nadie que lo hiciera en absoluto.
- Errores de costo medio. Extracción de una factura total mal. Perdiendo un mensaje urgente. Aquí, el sistema marca casos de baja confianza para un humano, y los humanos revisan aquellos más que todo.
- Errores de alto costo. Malinterpretar una obligación contractual. Desclasificar un aviso legal. Aquí, NLP se prepara y una persona decide, cada vez.
- El diseño. Los umbrales de confianza establecidos por tipo de documento. Por encima del umbral, el sistema actúa. Debajo, una persona mira. El umbral se mueve mientras se gana la confianza.
- La medición. Precisión en una muestra comprobada por una persona, mensual, por tipo de documento. Y la tasa de error del proceso manual que sustituyó, que nunca fue cero tampoco.
Donde NLP falla
- Documentos que nunca ha visto. Un nuevo diseño de formularios, un nuevo formato de factura del vendedor. Aprende, pero los primeros van a una persona.
- Ambigüedad que necesita contexto no tiene. "Cancelar la orden" cuando el cliente tiene tres órdenes abiertas.
- Sarcasmo e ironía. Todavía es difícil.
- Pobres insumos. Escaneos ilegíbles, audio con ruido de fondo pesado, texto en un idioma que el sistema no se estableció para.
- Cualquier cosa que requiera juicio sobre las consecuencias. NLP dice que un mensaje es una amenaza legal. Decidir qué hacer al respecto es el trabajo de un humano.
- El patrón. NLP falla en los bordes, y los bordes van a la gente. El centro —el ochenta por ciento del texto rutinario— es donde estaban las horas.
Privacidad y manejo
El texto a menudo contiene la información más sensible que un negocio tiene.
- Qué saber antes de empezar. Los documentos contienen información personal, financiera, sanitaria o jurídica. Cuando el texto es procesado y almacenado. Quién puede ver las salidas. Cuánto tiempo se retiene todo.
- Las reglas. Vary by jurisdiction and sector, and counsel maps them before any document type is processed.
- Las opciones de diseño. Redactar campos sensibles antes del procesamiento cuando sea posible. Procesamiento dentro de entornos controlados. Lograr cada acceso. Eliminar lo que no necesita ser guardado.
- Consentimiento. Para grabaciones, para mensajes, para cualquier procesamiento que el cliente no esperaría. Confirmado, no asumido.
Los primeros 90 días
Días 1–30: elija el tipo de documento
El texto que el negocio maneja por volumen y por horas: triaje de caja, facturas, comentarios, notas de llamada. El que tiene el mayor volumen y el menor costo por error elegido primero. El proceso actual midió: horas, tasa de error, tiempo de respuesta. Reglas de privacidad para ese tipo de documento confirmadas.
Días 31-60: construir y ejecutar en paralelo
La clasificación o extracción establecida para ese tipo de documento. Los umbrales de confianza establecidos. Una persona comprueba cada salida durante dos semanas mientras el proceso manual continúa. Precisión medida contra la base manual.
Días 61-90: lanzamiento y expansión
El sistema maneja los casos de alta confianza; una persona maneja los casos marcados. Horas devueltas, errores y tiempo de respuesta en comparación con el Día 1. El segundo tipo de documento elegido.
En la práctica, con Astra
Astra Results Marketing comienza con el tipo de documento, no el modelo: el texto que el negocio maneja por volumen y horas, el costo de un error para cada, y las reglas de privacidad que se aplican. El primer despliegue es el tipo de riesgo más alto y más bajo, se ejecuta en paralelo con umbrales de confianza fijados por tipo y medidos en base manual.
Debido a que el mismo equipo ejecuta la ingesta y automatización, el texto clasificado y extraído fluye en los flujos de trabajo que actúan en él en lugar de en otra bandeja de entrada. Los compromisos comienzan con una auditoría de volumen de documentos a través de nuestra consultoría empresarial equipo.
Lecturas relacionadas
Preguntas frecuentes
¿Qué hace el procesamiento del lenguaje natural para un negocio?
Se convierte en texto no estructurado —emails, contratos, reseñas, entradas, facturas, transcripciones de llamadas, formularios— en datos estructurados en los que un sistema puede actuar. Cinco trabajos cubren la mayoría de las necesidades: clasificar lo que es un texto, extraer los campos que importan, resumir la versión larga, leer el sentimiento a través de miles de mensajes, y enrutar cada artículo a la persona adecuada con la urgencia correcta.
¿Cómo es la NLP moderna diferente de las herramientas de texto más antiguas?
Las herramientas más antiguas se basaron en palabras clave y reglas y rompieron cualquier cosa inesperada. Los modelos de lenguaje moderno leen la forma en que una persona lo hace, manejando el contexto, los tipos, los lenguajes esclavizados y mixtos, por lo que las tareas que falló hace cinco años funcionan ahora. La disciplina alrededor de ellos — umbrales de confianza, revisión humana en los bordes, precisión medida— es lo que los hace confiables en un negocio.
¿Qué caso NLP paga primero?
Por lo general, la extracción de documentos, porque elimina la corrección: campos de facturas en cuentas por pagar, órdenes de compra en el sistema de pedidos, términos de contrato en un registro de búsqueda, formularios en registros. La clasificación de la caja y el enrutamiento es un segundo cercano para cualquier negocio con una dirección compartida recibiendo cientos de mensajes al día. La precisión depende de la calidad del documento: los archivos PDF limpios son excelentes, la escritura descolorida mantiene un trabajo humano.
¿Qué precisión es suficiente?
Depende de lo que un error cuesta, no de un porcentaje. Para errores de bajo costo como una revisión mal etiquetada, noventa por ciento con fácil corrección es excelente porque la alternativa no era nadie que lo hiciera. Para errores de costo medio como un total de factura incorrecto, el sistema marca casos de baja confianza para una persona. Para errores de alto costo como una obligación contractual, NLP se prepara y una persona decide cada vez.
¿Dónde falla NLP?
En los bordes: documentos que nunca ha visto, ambigüedad que necesita contexto carece, sarcasmo, escaneos ilegibles y audio ruidoso, y cualquier cosa que requiera juicio sobre las consecuencias. Puede leer que un mensaje es una amenaza legal; decidir qué hacer es el trabajo de un humano. Los bordes van a la gente. El centro —el ochenta por ciento del texto rutinario— es donde estaban las horas.
¿Y la privacidad?
El texto contiene la información más sensible que un negocio tiene. Antes de procesar cualquier tipo de documento, los mapas de abogados que se aplican por jurisdicción y sector, y el diseño sigue: la remodelación de campos sensibles cuando sea posible, el procesamiento en entornos controlados, el registro de todos los accesos, la eliminación de lo que no es necesario mantener, y la confirmación de consentimiento para grabaciones y mensajes en lugar de asumirlo.
¿Listo para cambiar la reorganización y la adoración en el trabajo estructurado? Astra Results Marketing audita el texto que tu negocio maneja por volumen y horas, comienza con el tipo de documento de mayor volumen y menor riesgo, y mide precisión contra la línea de referencia manual antes de que cualquier cosa funcione solo. Astra Results Marketing · 1101 Brickell Ave, Miami, FL 33131 · +1 (786) 321-2866 · [email protected] Encuéntranos. Google · Yelp ▸ LLAMAR AL (786) 321-2866 · ▸ SOLICITE SU CONSULTA